Rollerball 智能迷宫 | 开源项目分享
Rollerball是一款运行于PSOC Edge E84 双核开发板的智能迷宫强化学习演示项目,基于M33与M55双核架构与RT-Thread操作系统构建,将体感交互、图形渲染与强化学习算法整合起来,形成可直接部署的嵌入式应用。
项目支持导入外部AI生成的10×10随机迷宫,用户可通过倾斜开发板的体感操作控制小球通关;同时在开发板本地实现随机策略、Q-learning与DQN三类智能体的训练与推理,在统一的迷宫环境、动作规则与奖励机制下,通过LVGL图形界面直观对比人工操作与不同算法的通关成功率、路径步数与性能差异,让强化学习的训练效果与算法差距可被直观观测。
目录 |
01 |
项目概述 |
02 |
系统架构 |
03 |
功能介绍 |
04 |
软件结构 |
05 |
软件核心代码 |
06 |
完整使用教程 |
07 |
演示视频素材 |
08 |
获取同款硬件 |
项目概述
Rollerball是一个运行在 Infineon E84 开发板上的智能迷宫演示项目。用户可以将外部 AI 生成的 10x10 迷宫导入开发板,通过倾斜开发板控制屏幕中的小球完成迷宫,并依次观察随机策略、Q-learning 和 DQN 在同一张地图上的训练与推理结果。
项目将传感器交互、图形界面和强化学习算法组合在一个可直接展示的嵌入式应用中,最终通过对比页面展示人工操作与不同算法的成功情况、路径步数及差距,使算法效果能够在开发板屏幕上被直观观察。
项目目标
使用板载 IMU 将开发板倾斜动作转换为迷宫方向指令。
支持导入外部 AI 生成的随机地图,避免演示结果依赖固定地图。
在开发板本地运行随机策略、Q-learning 和 DQN。
使用 LVGL 实时显示迷宫、小球、训练状态、推理轨迹和结果对比。
采集人工操作轨迹,为默认地图上的 Q-learning 预训练提供演示样本。
通过统一迷宫环境保证不同策略使用相同地图、动作空间和奖励规则。
系统架构
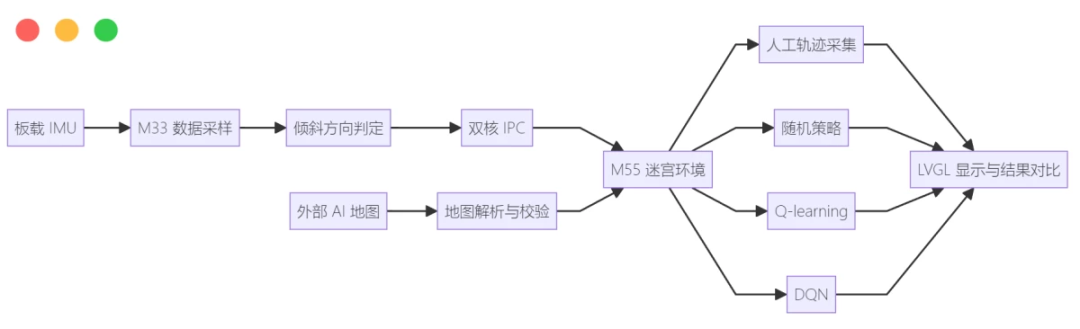
项目由 M33 和 M55 两个工程组成,两侧均运行 RT-Thread:
M33:读取 LSM6DS3 IMU、判定倾斜方向、处理复位事件,并通过 IPC 发送给 M55。
M55:接收 IPC 数据、运行迷宫环境、绘制 LVGL 界面,并执行随机策略、Q-learning 和 DQN。
功能介绍
随机地图导入
外部 AI 按约定生成两条 map_rows 命令。M55 接收完整的 10x10 地图后,会检查:
每个单元格是否只包含 0、1、2、3。
是否恰好存在一个起点和一个终点。
起点到终点是否可以通过上下左右移动到达。
当前是否有算法任务正在运行。
地图通过校验后立即显示在屏幕上,同时清空上一张地图对应的人工样本、随机策略统计、Q 表和 DQN 状态,避免不同地图的数据互相污染。
IMU 人工控制
M33 每 50 ms 读取一次 IMU,通过双阈值迟滞判断倾斜方向。一次倾斜只发送一次有效移动事件,开发板回正后才允许触发下一步,因此小球会在迷宫中逐格移动。
M55 接收方向后执行迷宫动作,实时记录移动前状态、动作、奖励、移动后状态、碰撞结果和完成标志,并同步刷新 LVGL 小球位置。
随机策略基线
随机策略在每一步等概率选择一个方向,用于提供不经过学习的基线结果。系统统计总回合数、成功回合数、成功回合平均步数和最少步数。
该结果用于说明迷宫并非依靠随机动作就能稳定完成,也为 Q-learning 和 DQN 的训练效果提供对照。
Q-learning
Q-learning 使用 100 个离散位置状态和 4 个方向动作构成 Q 表,并采用 epsilon-greedy 策略平衡探索与利用。每完成一个回合后降低探索率,训练结束后使用当前 Q 表进行贪心推理。
默认地图支持使用人工轨迹执行 q_pretrain,为人工走过的动作增加初始偏好;运行时导入的随机地图则直接从 q_train 开始训练。
DQN
DQN 使用 100-32-16-4 的全连接神经网络,将 100 个迷宫状态映射为 4 个动作价值。实现包含在线网络、目标网络、容量为 512 的经验回放缓冲区、16 条样本的批量训练、epsilon-greedy 探索和目标网络周期同步。
训练完成后,DQN 关闭随机探索,使用在线网络输出的最大 Q 值动作进行推理,并在屏幕上逐步显示路径。
策略结果对比
对比页面在同一张地图上汇总以下结果:
策略 |
展示内容 |
随机策略 |
成功回合数、成功回合平均步数 |
人工操作 |
最近一次完整人工轨迹步数 |
Q-learning |
最近一次推理结果、步数、与人工步数的差距 |
DQN |
最近一次推理结果、步数、与人工步数的差距 |
空闲功耗管理
系统在空闲时自动进入低功耗姿态,检测到交互后自动恢复:
M55:连续 30 秒无手势事件、无命令且无算法任务运行时,先在屏幕底部提示 Sleeping soon, tilt to wake,5 秒后关闭 LCD 背光并暂停 LVGL 渲染;倾斜、复位或任意模式命令会立即唤醒并全量重绘。休眠期间的第一次倾斜只用于唤醒屏幕,不会作为迷宫动作或人工样本。
M33:连续 60 秒未检测到倾斜时,IMU 采样周期从 10 ms 放宽到 100 ms,IPC 发送周期从 50 ms 放宽到 500 ms;倾斜后立即恢复,整机唤醒延迟不超过约 0.7 秒。
此外,两核的 RT-Thread 空闲线程均注册了 WFI 钩子:没有就绪任务时内核进入时钟门控,由下一个中断唤醒,使降低唤醒频率的收益真正转化为内核电流的下降。
训练和推理期间视为持续活动,长任务运行中不会熄屏。相关命令:power_stats、power_timeout、power_sleep、power_wake。
软件结构
rollerball/├── M33/applications/│ ├── module_imu.c/.h # IMU 初始化、采样与数据接口│ ├── app_gesture.c/.h # 倾斜方向判定│ ├── app_ipc_tx.c # IMU 方向与复位事件发送│ ├── app_maze.c/.h # 实体按键及软件复位事件│ └── app_maze_protocol.h # 双核共享协议└── M55/applications/ ├── app_ipc_rx.c # IPC 接收、人工动作执行与轨迹采集 ├── app_map_loader.c # 地图命令解析、校验与切换 ├── module_maze_env.c/.h # 统一迷宫环境和奖励规则 ├── app_demo_collector.c/.h # 人工演示样本缓存 ├── app_random_baseline.c/.h# 随机策略基线 ├── module_q_agent.c/.h # Q-learning 智能体 ├── app_q_training.c/.h # Q-learning 训练与推理任务 ├── module_dqn_agent.c/.h # DQN 网络与经验回放 ├── app_dqn_training.c/.h # DQN 训练与推理任务 ├── app_algorithm_manager.* # 算法任务互斥管理 ├── app_mode_manager.* # 页面工作模式管理 ├── app_power_manager.* # 空闲功耗管理 ├── app_maze_ui.c/.h # LVGL 迷宫及统计页面 └── app_ball_ui.c/.h # 小球绘制与位置更新
软件核心代码
以下代码均为工程当前实现的关键逻辑节选,完整实现以对应源文件为准。
倾斜方向判定
文件:M33/applications/app_gesture.c
双阈值迟滞可以防止加速度值在阈值附近波动时重复切换方向。
if(prev == GESTURE_LEFT && ax > TILT_THRESH_OFF_MG)returnGESTURE_LEFT;if(prev == GESTURE_RIGHT && ax < -TILT_THRESH_OFF_MG) return GESTURE_RIGHT;if (prev == GESTURE_UP && ay > TILT_THRESH_OFF_MG)returnGESTURE_UP;if(prev == GESTURE_DOWN && ay < -TILT_THRESH_OFF_MG) return GESTURE_DOWN;if (ax > TILT_THRESH_ON_MG)returnGESTURE_LEFT;if(ax < -TILT_THRESH_ON_MG) return GESTURE_RIGHT;if (ay > TILT_THRESH_ON_MG)returnGESTURE_UP;if(ay < -TILT_THRESH_ON_MG) return GESTURE_DOWN;return GESTURE_NONE;
单次倾斜事件与 IPC 帧
文件:M33/applications/app_ipc_tx.c
gesture_armed 保证持续倾斜不会连续产生多步动作;回正后才重新允许触发。
if(gesture == GESTURE_NONE){ gesture_armed = RT_TRUE;}elseif(gesture_armed){ event_sequence++; gesture_armed = RT_FALSE;}tx_frame.role = RC_ROLE_M33;tx_frame.magic = RC_MAGIC_WORD;tx_frame.seq = event_sequence;tx_frame.channel[IMU_CH_DIRECTION] =gesture_to_wire(gesture);tx_frame.channel[IMU_CH_RESET_GENERATION] =maze_app_reset_generation();tx_frame.channel[IMU_CH_PAYLOAD] = IMU_GESTURE_PAYLOAD_V1;tx_frame.checksum =edge_rc_checksum(&tx_frame);rt_device_write(ipc_dev,0, &tx_frame,1);
地图校验与启用
文件:M55/applications/app_map_loader.c、M55/applications/module_maze_env.c
地图校验使用广度优先搜索计算起点到终点的最短路径。只有格式、起终点数量和可达性全部正确时才切换活动地图。
validation=maze_env_validate_map(s_staged_map,&shortest_path);if(validation!=MAZE_ENV_MAP_VALID){ rt_kprintf("[MAP] rejected: %s\n", validation_error(validation)); return-RT_EINVAL;}if(app_algorithm_is_busy()){ rt_kprintf("[MAP] rejected: algorithm task is busy\n"); return-RT_EBUSY;}validation=maze_env_set_map(s_staged_map,&shortest_path);
统一迷宫奖励规则
文件:M55/applications/module_maze_env.c
人工、随机策略、Q-learning 和 DQN 均调用同一个 maze_env_step(),因此四种方式使用完全一致的移动和碰撞规则。下表的环境奖励作用于人工、随机策略和 Q-learning;DQN 训练为了匹配神经网络的数值范围,改用独立的归一化塑形奖励(终点 +1.0、碰撞 -0.1、移动 -0.01,并叠加 0.05 × 靠近终点的距离增益)。
if(next_x < 0 || next_x >= (int)MAZE_ENV_SIZE || next_y < 0 || next_y >= (int)MAZE_ENV_SIZE || map[next_y][next_x] == MAZE_ENV_CELL_WALL){ env->collision_count++; env->cumulative_reward -= 2.0f; if(reward != RT_NULL) { *reward = -2.0f; } returnMAZE_ENV_STEP_COLLISION;}env->agent_x = (rt_uint8_t)next_x;env->agent_y = (rt_uint8_t)next_y;if(maze_env_is_done(env)){ env->cumulative_reward += 100.0f; if(reward != RT_NULL) { *reward = 100.0f; } returnMAZE_ENV_STEP_GOAL;}env->cumulative_reward -= 0.1f;if(reward != RT_NULL){ *reward = -0.1f;}returnMAZE_ENV_STEP_MOVED;
当前环境奖励设计为:
行为 |
奖励 |
正常移动一步 |
-0.1 |
碰撞或越界 |
-2 |
到达终点 |
100 |
Q-learning 更新
文件:M55/applications/module_q_agent.c
Q-learning 使用标准时序差分更新公式:
Q(s,a) <- Q(s,a) + alpha * [r + gamma * max Q(s',a') - Q(s,a)]
对应实现:
current_value = agent->q_values[state][action];target_value = reward;if (!done){ target_value += agent->discount_factor * q_agent_max_value(agent, next_state);}agent->q_values[state][action] = current_value + agent->learning_rate * (target_value - current_value);
DQN 网络和批量训练
文件:M55/applications/module_dqn_agent.h、M55/applications/module_dqn_agent.c
网络规模和经验回放参数:
#defineDQN_AGENT_HIDDEN1_SIZE 32U#defineDQN_AGENT_HIDDEN2_SIZE 16U#defineDQN_AGENT_REPLAY_CAPACITY 512U#defineDQN_AGENT_BATCH_SIZE 16U
批量训练从经验回放中随机采样,使用目标网络计算 TD 目标,并周期性同步目标网络:
constdqn_transition_t *transition = &agent->replay[(dqn_random(agent) >>16) % agent->replay_count];float target_value = transition->reward;if(!transition->done){ target_value += agent->discount_factor * network_max_q(&agent->target_network, transition->next_state);}total_loss += network_train_transition(&agent->online_network, transition, target_value, agent->learning_rate);if(agent->train_updates % DQN_TARGET_SYNC_INTERVAL == 0U){ memcpy(&agent->target_network, &agent->online_network, sizeof(agent->target_network));}
算法任务互斥
文件:M55/applications/app_algorithm_manager.c
随机策略、Q-learning、DQN 和推理任务共享一个互斥管理器。地图切换或另一算法启动时,如果已有任务运行,接口会返回 -RT_EBUSY,防止多个任务同时修改状态或抢占计算资源。
rt_mutex_take(&s_algorithm_lock,RT_WAITING_FOREVER);if(s_active_algorithm !=APP_ALGORITHM_NONE){ result = -RT_EBUSY;}else{ s_active_algorithm = algorithm;}rt_mutex_release(&s_algorithm_lock);
完整使用教程
演示前准备
确认 M33 与 M55 工程均已烧录并正常运行。
打开 M55 的 FinSH/MSH 串口终端,地图和算法命令均在该终端执行。
如需诊断 IMU 或手动发送复位事件,再打开 M33 的串口终端。
每次加载新地图后,人工样本、随机策略统计、Q-learning 和 DQN 数据都会被清空,因此应按本节顺序完成一次完整演示。
训练任务在后台执行。看到对应的 train complete 或 complete 日志后,再执行下一条命令。
步骤一:获取并确认当前虚拟地图
在 M55 终端执行:
map_show
终端会输出当前地图版本、最短路径长度,以及两条可再次加载的 map_rows 命令。地图编码含义:
数值 |
含义 |
0 |
可通行区域 |
1 |
墙 |
2 |
起点,整张地图必须恰好一个 |
3 |
终点,整张地图必须恰好一个 |
如需使用外部 AI 生成随机地图,将 6.5 节的提示词发给 AI,把返回的两行命令依次粘贴到 M55 终端。例如:
map_rows02000000000,1111110111,0000000000,0110111110,0000000000map_rows50111111110,0000000000,0111011100,0000000003,0111111110
第二条命令执行后,开发板会自动校验并启用地图,成功日志应包含:
[MAP] accepted revision=... shortest_path=...[MAP] Q table, DQN, random baseline,anddemo data cleared
再次执行 map_show 确认屏幕和终端地图一致。若第一段已输入但决定放弃,可执行 map_abort。
步骤二至七:人工、随机、Q-learning、DQN 与对比
人工控制迷宫:执行 maze_mode demo,拿起开发板前后左右倾斜控制小球,每次倾斜触发一步、回正后再进行下一次倾斜。完成后执行 demo_stats 验收:样本数大于 0,最近一条样本 done=1。需要重新采集时先在 M33 终端执行 maze_reset 复位小球,demo_clear 仅在确实需要清空人工样本时使用。
随机策略基线:依次执行 random_reset、random_run 100,等待 [RANDOM] complete episodes=100 success=... 后执行 random_stats。avg_success_steps 只统计成功回合,best_steps 为成功回合中的最少步数。
Q-learning:依次执行 q_reset、q_train 500,等待 [Q] train complete episodes=500 success=... 后执行 q_infer 和 q_stats。验收 [Q] infer success=1 steps=... reward_x10=...;推理失败可继续 q_train 500 加练后再推理,但继续训练前不要执行 q_reset。q_pretrain 仅支持内置默认地图,随机地图直接用 q_train。
DQN:依次执行 dqn_reset、dqn_train 1000,等待 [DQN] train complete episodes=1000 success=... 后执行 dqn_infer 和 dqn_stats。验收 [DQN] infer success=1 steps=... reward_x10=...;推理失败可继续 dqn_train 1000 后再推理,但继续训练前不要执行 dqn_reset(会清空网络、经验回放和统计数据)。
最终对比:确认人工、随机、Q-learning、DQN 均已产生结果后执行 maze_mode compare,对比页显示随机策略成功回合数与平均步数、人工最近一次步数、Q-learning/DQN 最近一次推理结果及其与人工步数的差距。某项显示 -- 表示尚未产生有效结果,显示”失败”表示最近一次推理未到达终点。
空闲功耗管理演示
放置 30 秒无操作后屏幕右下角出现 Sleeping soon, tilt to wake 提示,5 秒后关闭背光并暂停渲染;倾斜、复位或任意模式命令可立即唤醒。也可用 power_sleep 立即触发休眠、power_wake 唤醒、power_timeout <10-600> 调整超时秒数、power_stats 查看当前状态,避免现场演示真等 30 秒。训练与推理期间视为持续活动,不会熄屏。
外部 AI 地图生成提示词
将以下内容完整发送给外部 AI:
请为一个嵌入式设备上的迷宫强化学习演示生成一张 10x10 随机地图。地图规则:1.地图固定为 10 行、10 列。2.每个格子只能使用数字 0、1、2、3。3.0 表示可通行区域,1 表示墙,2 表示起点,3 表示终点。4.整张地图必须恰好包含一个起点 2 和一个终点 3。5.起点到终点必须存在至少一条由上下左右移动组成的可达路径,不允许斜向移动。6.地图应具有适中的迷宫复杂度,包含转弯和分支,但不要只有唯一的一条狭长通道,也不要生成大面积完全开放区域。7.请自行检查行列数、字符合法性、起点和终点数量以及连通性。输出规则:1.最终只能输出下面格式的两行命令,不要解释、序号、Markdown 代码块、引号或其他内容。2.每个 row 必须正好包含 10 个数字。3.每条命令包含连续 5 行地图,行与行之间只用英文逗号分隔,数字之间不能有空格。4.第一条命令必须从 map_rows 0 开始,第二条命令必须从 map_rows 5 开始。严格输出格式:map_rows 0 row0,row1,row2,row3,row4map_rows 5 row5,row6,row7,row8,row9
常用辅助命令
M55 终端
命令 |
作用 |
map_show |
输出当前地图及可复用的加载命令 |
map_abort |
放弃尚未完成的地图加载 |
demo_stats |
查看人工轨迹采集统计 |
demo_clear |
清空人工轨迹 |
random_stats |
查看随机策略统计 |
q_stats |
查看 Q-learning 状态 |
dqn_stats |
查看 DQN 状态 |
maze_mode compare |
打开最终策略对比页 |
power_stats |
查看空闲功耗管理状态 |
power_timeout |
设置屏幕空闲超时(秒) |
power_sleep |
立即进入屏幕休眠 |
power_wake |
唤醒屏幕 |
M33 终端
命令 |
作用 |
imu_print |
打印当前加速度计和陀螺仪数据 |
gesture_print |
打印当前倾斜方向判定 |
maze_reset |
向 M55 发送迷宫复位事件 |
maze_print |
查看当前复位事件编号 |
继续浏览有关 软件 的文章