Firefly RK1828 多卡级联本地部署方案
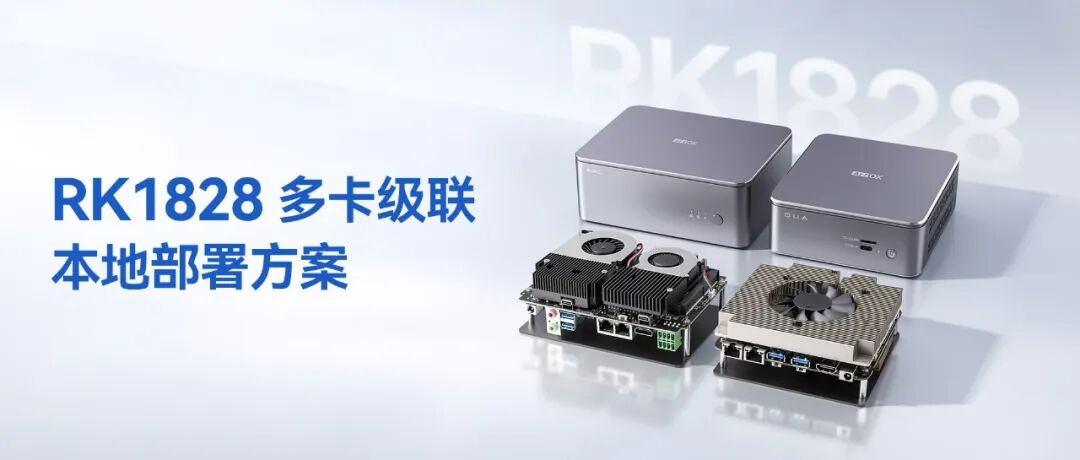
当 AI 从云端走向设备现场,单块端侧 NPU 的算力与内存有限,我们基于 RK3588 主控与 RK1828 NPU 加速卡的多卡级联架构,将多块 NPU 的算力与内存统一调度、协同推理,让大参数模型、视觉理解、语音处理与 Agent 工具能力部署到本地设备,从单卡 7B 轻量推理、双卡 12B、再到 4 卡 27B 推理的灵活扩展。
产品介绍
双卡级联系列
四卡级联系列
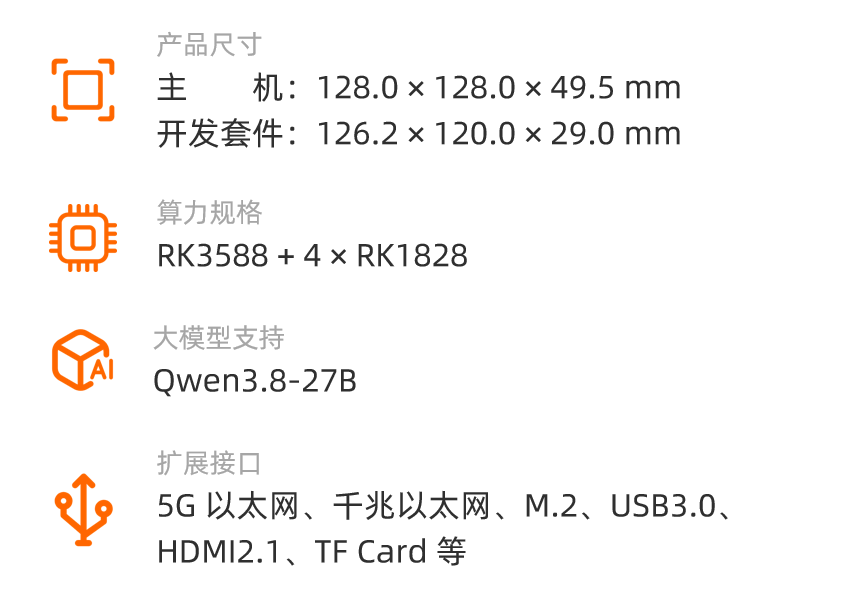
RK3588 + N × RK1828
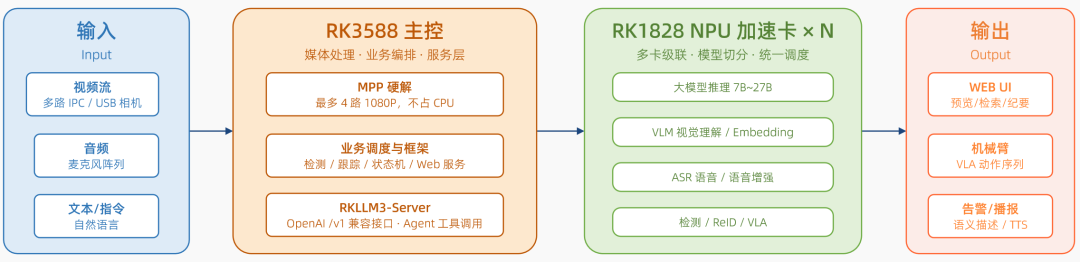
运行流程
方案优势
算力弹性扩展
PCIe 多卡级联统一调度,单卡 7B → 双卡 12B → 4 卡 27B 按需选型,多卡切分跨卡分布式推理;
主控轻载零压力
推理全部卸载至 RK1828,RK3588 CPU 占用仅 2.4%~2.6%,专注编解码、业务逻辑与服务编排;
解码与推理并行
MPP 硬解与 NPU 推理硬件级隔离,多路视频解码不抢 CPU、推理不卡预览,多机位场景稳定流畅;
端侧低功耗
双卡系统均功耗 30.5W、四卡 57.8W,无 GPU 服务器的功耗、体积与散热负担,适合嵌入式部署;
数据本地闭环
大模型 / VLM / ASR 全部板端推理,录音与画面不出内网,断网环境稳定运行,满足私有化要求;
生态即插即用
OpenAI /v1 兼容接口,OpenClaw / Nanobot 等 Agent 框架直连,MCP 工具注册即扩展设备能力。
性能表现
多卡大模型推理性能
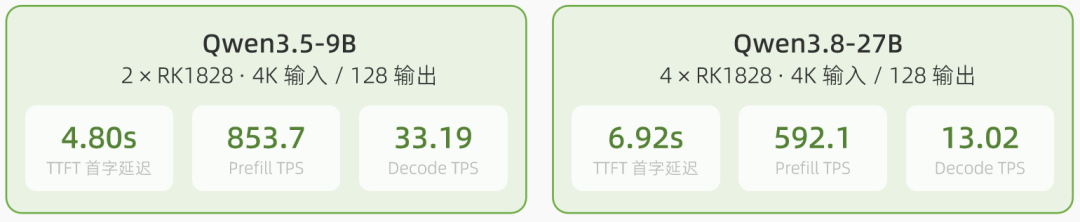
RK3588 Host · RK1828 SO-DIMM · 模型量化 W4A16 · PCIe 接口实测
主控开销极低
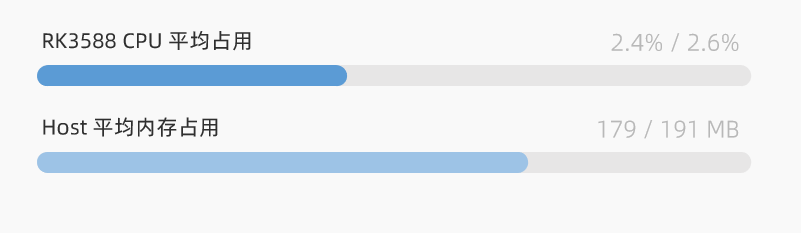
Qwen3.5-9B(2卡)/ Qwen3.8-27B(4卡)推理全程,RK3588 以 4 核 A76 计,CPU 几乎空载,业务与硬解余量充足。
整机功耗友好
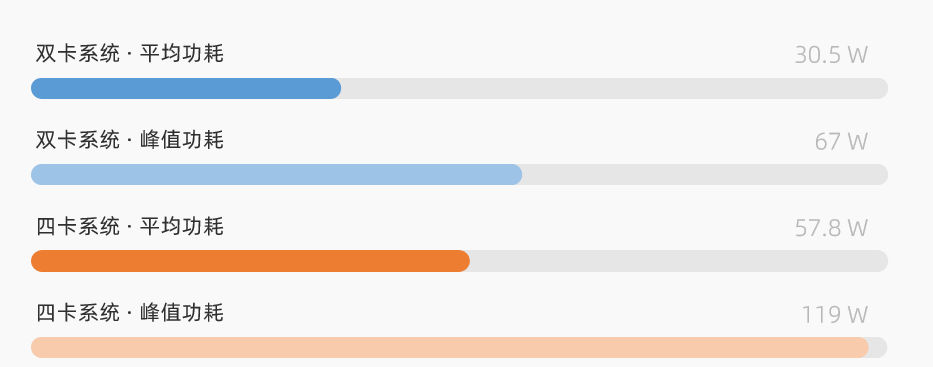
27B 级推理整机功耗与一台笔记本相当,无需独立供电与机房环境。
案例1:多模态推理与语义检索
方案介绍
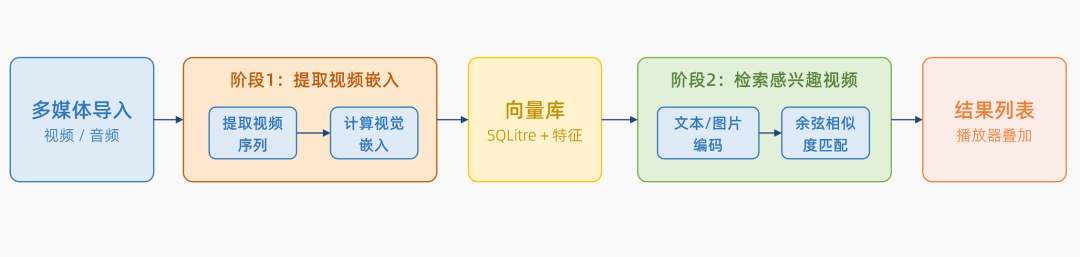
本方案基于 RK3588 + RK1828 构建本地化多机位行人检索系统,采用纯 ReID 技术路线:对每段视频按 0.5 秒间隔抽帧,先用 YOLOv8 完成行人检测并做几何门限过滤与 NMS,再经 OSNet 提取 512 维外观特征形成带时间段的轨迹,在同一视频内以贪心余弦聚类(阈值 0.85)合并为同一人,最后跨视频匹配,把同一行人在不同机位、不同时间的出现关联起来。
Demo演示
应用场景
适合园区、小区、商场的多机位行人检索(走失查找、轨迹回溯)、监控素材批量分析归档与运动姿态分析等场景。
案例2:多卡级联 + 本地 Agent
方案介绍
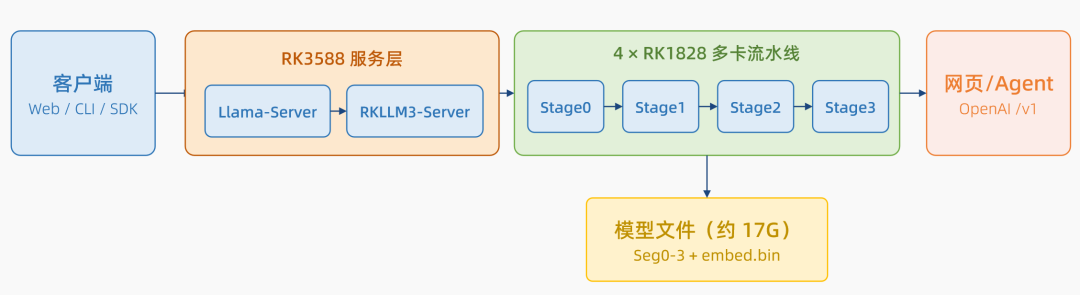
面向"大模型要塞进边缘设备"的需求:通过多卡切分把模型按卡数拆分,在多张 RK182X 上跨卡分布式推理,使 Qwen3.5-27B、Qwen3.8-27B、gemma-4-31B 这类四卡组合,以及 Qwen3.5-9B、gemma-4-12B 这类两卡组合能够落到板端运行。
Demo演示
应用场景
适合端侧大模型私有部署、多卡推理服务、局域网内提供 OpenAI 兼容接口等场景。部署需多张 RK182X,且所选模型必须有对应的多卡 RKNN 产物(并非任意模型都能自动切分)。
继续浏览有关 级联 的文章
